NVIDIA Vera CPU 출하 시작: AI 에이전트의 병목이 GPU 밖으로 이동한다
NVIDIA가 에이전트 작업용 Vera CPU를 AWS·OCI와 주요 AI 연구소에 공급하기 시작했다. 88개 코어와 고대역폭 메모리가 겨냥하는 실제 병목, 공개 수치를 읽을 때의 주의점을 짚는다.
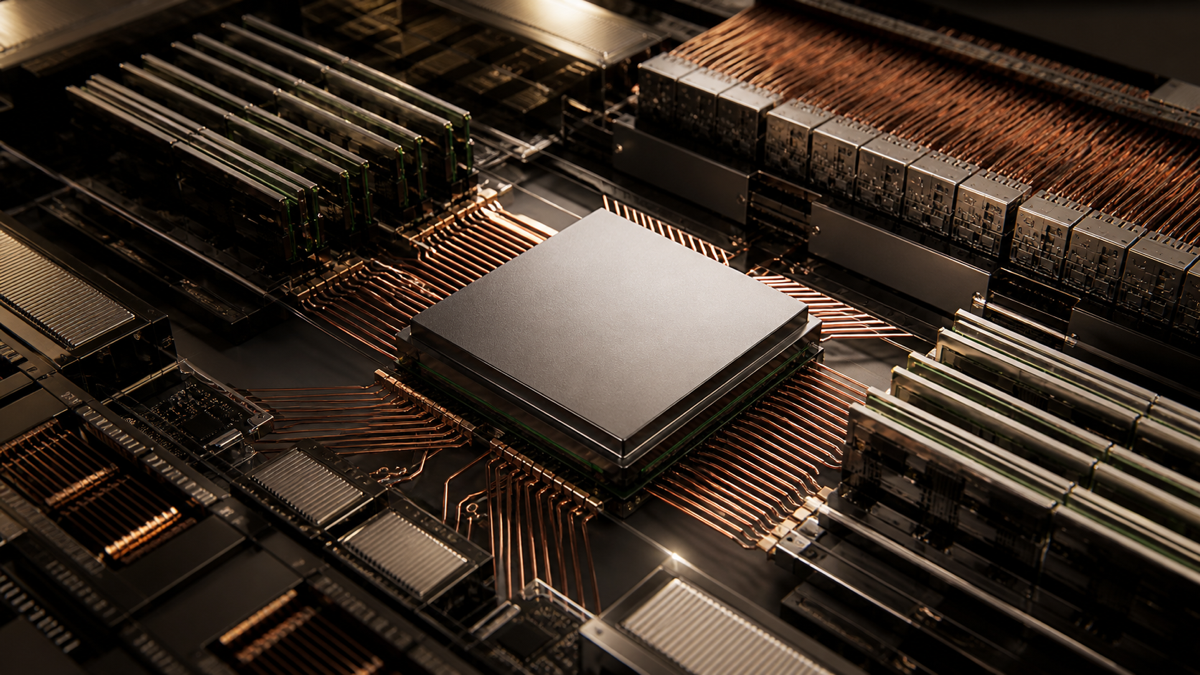
NVIDIA가 2026년 8월 27일 자체 설계 데이터센터 CPU인 Vera의 대규모 출하가 시작됐다고 밝혔다. AWS는 첫 Vera CPU 서버와 Vera Rubin GPU를 받았고, 앞서 Anthropic·OpenAI·Oracle Cloud Infrastructure(OCI)·SpaceXAI에도 평가 또는 도입용 시스템이 전달됐다. GPU가 모델의 행렬 연산을 맡는 동안 코드 실행, 도구 호출, 검색, 샌드박스 관리와 작업 조율을 처리하는 CPU 쪽을 별도 최적화하려는 시도다.
무엇이 달라졌나
Vera는 NVIDIA가 처음부터 설계한 88개 Olympus 코어와 초당 1.2TB 메모리 대역폭을 갖춘다. NVIDIA는 에이전트형 AI 작업에서 코어당 성능이 기존 주요 x86 CPU보다 최대 1.8배 높고, 샌드박스 환경 성능은 최대 80% 빠르다고 주장한다. 독립 CPU 서버로도 쓰이며, Vera Rubin NVL72에서는 2세대 NVLink-C2C1로 Rubin GPU 두 개의 호스트 프로세서 역할을 맡는다.
이번 발표의 의미는 사양 공개가 아니라 실제 공급 단계로 넘어갔다는 데 있다. NVIDIA에 따르면 OCI는 2026년부터 수십만 개 Vera CPU를 배치할 계획이며, AWS도 Vera 기반 인프라 도입을 준비한다. 다만 ‘시스템 전달’과 일반 고객이 즉시 주문해 쓰는 상용 서비스 출시는 같은 말이 아니다. 각 클라우드의 인스턴스 이름, 지역, 가격과 서비스 개시일은 별도 발표를 기다려야 한다.
왜 에이전트에 CPU가 중요한가
긴 추론 작업은 GPU 호출만 반복하지 않는다. 모델이 만든 Python 코드를 컴파일하고 실행하거나, 수백 개 도구 요청을 분배하고, 문서 조각을 검색해 문맥을 구성하며, 격리 환경을 만들고 회수하는 과정은 CPU와 메모리 시스템에 부담을 준다. 동시 에이전트 수가 늘면 단일 코어의 반응성과 메모리 대역폭이 GPU 사용률과 사용자 체감 지연까지 좌우할 수 있다.
Vera가 LPDDR5X를 SOCAMM2 모듈로 제공하는 이유도 이 지점에 있다. NVIDIA는 기존 DDR5 기반 서버보다 메모리 대역폭이 두 배, 코어당 대역폭은 세 배라고 설명한다. 데이터를 제때 공급해 비싼 GPU가 기다리는 시간을 줄이겠다는 설계다.
실제 영향과 확인할 점
- 벤치마크의 분모: ‘최대 1.8배’는 NVIDIA가 선택한 에이전트 작업과 비교 시스템에서 나온 값이다. 조직의 도구 호출 비율, 샌드박스 수명, 코드 실행 시간으로 다시 측정해야 한다.
- 플랫폼 종속성: Arm 계열 환경으로 옮길 때 네이티브 확장, 컨테이너 이미지, 관측 도구와 보안 에이전트 지원을 확인해야 한다.
- 전체 비용: 토큰당 비용은 CPU 가격뿐 아니라 GPU 가동률, 전력, 메모리 용량, 네트워크와 운영 소프트웨어를 합쳐 비교해야 한다.
- 공급 일정: 전달된 초기 시스템과 고객이 쓸 수 있는 정식 클라우드 상품을 구분하고 지역별 가용성을 확인해야 한다.
Vera는 ‘AI 컴퓨트는 곧 GPU’라는 단순한 구도를 바꾸지만, 공개된 성능 수치는 아직 공급사 자료가 중심이다. 실제 워크로드에서 CPU 병목이 얼마나 큰지 먼저 프로파일링한 뒤, x86·기존 Arm 서버와 같은 조건에서 처리량과 지연을 비교하는 것이 합리적이다.
출처
1 NVLink-C2C: CPU와 GPU 같은 칩 사이를 높은 대역폭으로 연결하는 NVIDIA 인터커넥트. 2 SOCAMM: 저전력 메모리를 서버에서 교체 가능한 모듈로 구성한 규격.