llama.cpp로 로컬 AI 서버 만들기
GGUF 모델을 llama.cpp로 실행하고 터미널 대화부터 OpenAI 호환 로컬 API 연결, 성능 조정과 보안·복구까지 단계별로 안내합니다.
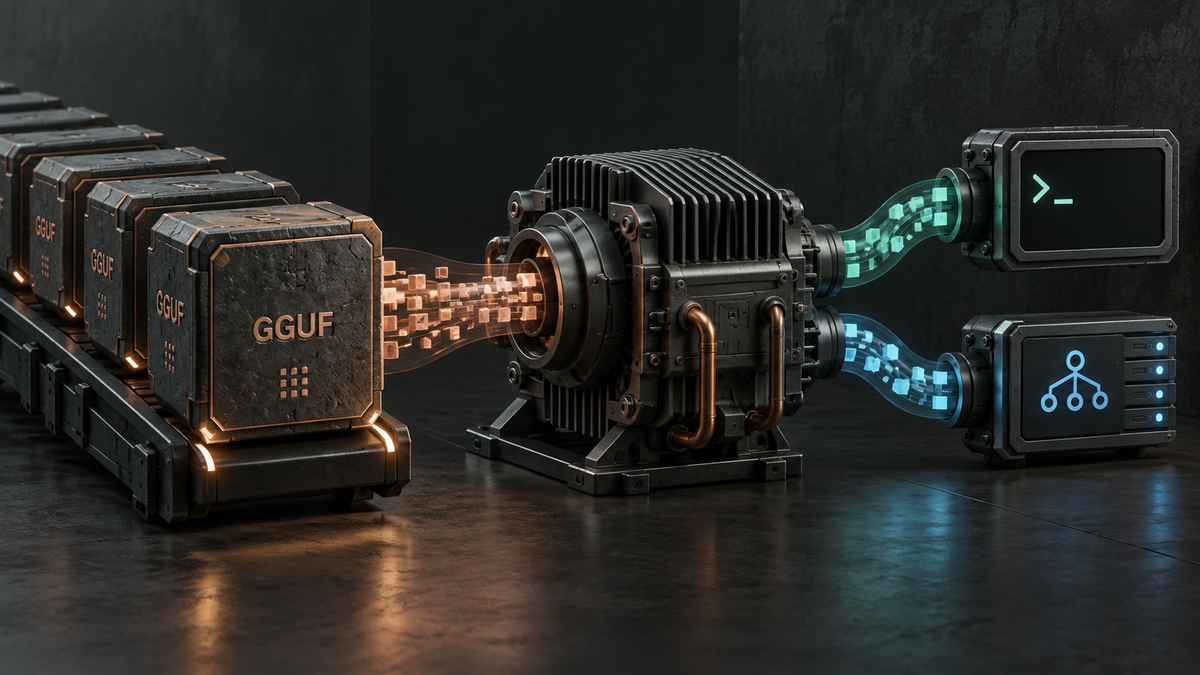
llama.cpp는 GGUF 형식의 언어 모델을 CPU와 다양한 GPU 백엔드에서 실행하고, 같은 모델을 터미널 대화나 로컬 API로 제공할 수 있는 C/C++ 기반 추론 도구입니다. Ollama처럼 모델 관리 경험을 감싸는 도구보다 한 단계 아래에서 모델 파일, 컨텍스트 길이, GPU 오프로딩과 서버 옵션을 직접 조정하고 싶은 개발자에게 잘 맞습니다.
무엇이 다른가
llama.cpp의 핵심은 모델 실행 경로를 직접 통제하는 데 있습니다. GGUF 파일 하나를 llama cli로 열어 대화할 수도 있고, llama serve로 같은 모델을 OpenAI 호환 API 뒤에 둘 수도 있습니다. Apple Silicon의 Metal, NVIDIA의 CUDA, AMD의 HIP, Vulkan 등 여러 백엔드를 지원하지만 실제 속도와 메모리 사용량은 하드웨어, 모델 크기, 양자화 방식과 컨텍스트 길이에 따라 크게 달라집니다.
설치와 확인
공식 설치 문서는 macOS와 Linux에서 다음 설치 스크립트를 권장합니다. 원격 스크립트를 바로 실행하는 방식이 부담스럽다면 공식 릴리스의 사전 빌드 파일, 패키지 관리자 또는 소스 빌드를 선택하세요.
curl -LsSf https://llama.app/install.sh | sh
llama cli --version
두 번째 명령에서 버전과 빌드 정보가 나오면 설치가 끝난 것입니다. 명령을 찾지 못하면 새 터미널을 열고 설치 안내가 추가한 PATH를 확인합니다. 회사 장비에서는 보안 정책에 따라 설치 스크립트 실행 전에 내용을 검토하거나 승인된 패키지 경로를 사용해야 합니다.
첫 모델 실행
공식 CLI는 Hugging Face의 GGUF 저장소를 -hf로 지정하면 호환 파일을 내려받아 캐시에 저장합니다. 아래 예시는 공식 문서의 소형 Gemma 계열 예시이며, 모델 저장소와 양자화 표기는 바뀔 수 있으므로 실행 전 공식 모델 페이지의 요구 메모리와 라이선스를 확인하세요.
llama cli -hf ggml-org/gemma-4-e4b-it-GGUF:Q4_0대화 프롬프트가 나타나면 로딩에 성공한 것입니다. 로컬 파일을 이미 받았다면 llama cli -m my-model.gguf처럼 지정합니다. 응답이 너무 느리거나 메모리 부족이 나면 더 작은 모델이나 더 강한 양자화를 선택하고, 컨텍스트 길이를 낮춰 다시 시작하는 것이 가장 단순한 진단 순서입니다.
API 서버 시작
애플리케이션에서 호출하려면 서버 모드가 편합니다. 기본값은 외부 네트워크가 아닌 127.0.0.1:8080에만 바인딩됩니다.
llama serve -hf ggml-org/gemma-4-e4b-it-GGUF:Q4_0 -c 4096 --alias local-model모델 로딩 중에는 상태 확인이 실패하거나 503을 반환할 수 있습니다. 다음 명령에서 200 응답과 정상 상태가 나오면 요청을 받을 준비가 된 것입니다.
curl -i http://127.0.0.1:8080/health이제 OpenAI 호환 채팅 엔드포인트를 호출합니다.
curl http://127.0.0.1:8080/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "local-model",
    "messages": [{"role": "user", "content": "세 문장으로 Git 브랜치를 설명해줘"}]
  }'
응답 JSON의 choices 안에 생성 문장이 있으면 CLI가 아닌 애플리케이션 연결까지 성공한 것입니다. OpenAI SDK를 쓰는 기존 코드라면 기본 URL을 http://127.0.0.1:8080/v1로 바꾸고, 서버에서 API 키를 요구하지 않을 때도 SDK 형식상 임의 문자열을 넣어야 할 수 있습니다.
주요 옵션
-c또는--ctx-size: 한 요청이 사용할 컨텍스트 토큰 범위입니다. 커질수록 메모리 사용량도 늘어납니다.-ngl또는--gpu-layers: GPU로 보낼 레이어 수입니다. 공식 최신 CLI에서는all,auto또는 숫자를 사용할 수 있습니다.-np또는--parallel: 동시에 처리할 슬롯 수입니다. 슬롯이 늘면 동시성은 좋아지지만 컨텍스트와 메모리 예산을 함께 나눕니다.--alias: API가 보고할 모델 이름을 단순하게 만듭니다.--api-key: 로컬 호스트 밖에서 사용할 때 요청 인증을 추가합니다.
옵션 이름과 기본값은 활발히 바뀔 수 있으므로 설치된 버전에서는 llama serve --help를 최종 기준으로 삼으세요.
보안과 한계
--host 0.0.0.0은 같은 네트워크의 다른 장치에서도 접속하게 하지만, 인증과 방화벽 없이 쓰면 모델 API가 그대로 노출됩니다. 외부 접근이 필요하면 --api-key를 설정하고 운영체제 방화벽 또는 역방향 프록시에서 허용 범위를 제한하세요. 프롬프트가 로컬에서 처리되더라도 -hf를 처음 실행할 때 모델 파일은 외부 저장소에서 다운로드됩니다.
모델 라이선스와 입력 데이터 취급 책임도 llama.cpp가 대신 해결하지 않습니다. 상업적 사용, 개인정보 처리, 모델 출력 검증은 선택한 모델의 약관과 조직 정책을 별도로 확인해야 합니다.
문제 해결
- 명령이 없으면 새 셸에서 PATH와
llama cli --version을 확인합니다. - 모델을 못 찾으면 Hugging Face 저장소 이름, GGUF 변형 표기와 네트워크 접근을 확인합니다.
- 메모리 부족이면 모델 크기·양자화·
-c값을 차례로 낮춥니다. - 서버가 준비되지 않으면
/health가 200이 될 때까지 로딩 상태를 확인합니다. - 다른 장치에서 접속이 안 되면
--host, 방화벽과 포트 매핑을 점검하되 인증 없는 공개 바인딩은 피합니다.
제거와 복구
실행 중인 CLI나 서버는 Ctrl+C로 중지합니다. 설치 제거 방식은 설치 경로에 따라 다르므로 패키지 관리자로 설치했다면 같은 관리자의 제거 명령을 사용하고, 공식 스크립트 설치라면 설치 위치와 캐시 디렉터리를 먼저 확인한 뒤 삭제하세요. 모델 캐시는 용량이 클 수 있으므로 다른 로컬 AI 도구와 공유하는 파일인지 확인한 후 정리합니다. 애플리케이션 연동을 되돌릴 때는 API 기본 URL을 원래 서비스 주소로 복원하면 됩니다.