MiniMax H3 공개: 영상 생성 AI가 ‘클립 도구’에서 멀티모달 제작실로 간다
MiniMax H3는 텍스트·이미지·영상·오디오를 하나의 맥락으로 읽고 최대 15초 2K 영상과 스테레오 사운드를 함께 생성합니다. 중요한 변화는 단일 클립 생성보다 복합 제작 워크플로를 한 모델로 묶으려는 방향입니다.
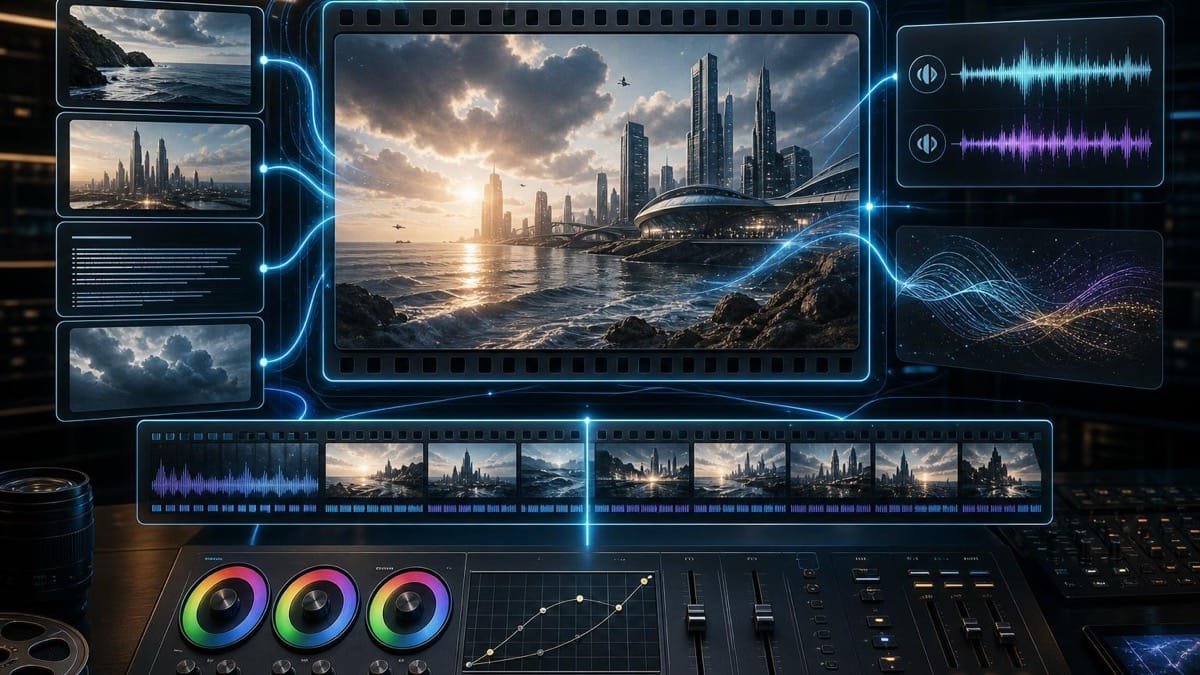
중국 AI 기업 MiniMax가 텍스트·이미지·영상·오디오를 한 번에 이해하는 영상 생성 모델 H3를 공개했습니다. 회사 발표 기준으로 H3는 최대 15초 길이의 2K 영상과 네이티브 스테레오 사운드를 함께 만들며, 여러 참조 자료의 관계를 자연어로 지정할 수 있습니다. 이는 “문장 하나로 짧은 영상을 만드는 도구”에서 이미지 레퍼런스, 카메라 움직임, 음성·효과음과 편집 의도를 함께 다루는 제작 시스템으로의 이동을 보여줍니다. 다만 성능과 가격 우위는 아직 회사 설명과 초기 벤치마크 중심이므로 실제 도입 전에는 자체 평가가 필요합니다.
H3가 새로 묶은 것
기존 생성형 영상 워크플로는 텍스트-투-비디오, 이미지-투-비디오, 첫·마지막 프레임 지정, 인물·스타일 참조, 모션 전이, 영상 편집과 오디오 생성이 서로 다른 모델이나 단계로 나뉘는 경우가 많았습니다. H3의 핵심은 이 작업 경계를 하나의 멀티모달 문맥 안으로 합치는 데 있습니다.
MiniMax가 든 예시는 구조를 잘 보여줍니다. 사용자는 한 영상의 카메라 움직임을 참고하고, 별도 이미지 속 인물을 등장시키며, 또 다른 오디오의 보컬에 맞춰 노래하게 하라는 관계를 자연어로 기술할 수 있습니다. 모델은 입력 파일을 단순히 나열하는 대신 참조 자료와 목표 영상 사이의 관계를 해석합니다.
공식 발표와 API 문서에 따르면 H3는 현재 MiniMax 플랫폼 API와 Hailuo AI에서 이용할 수 있습니다. 출력은 4~15초 범위의 2K 영상과 스테레오 오디오를 지원합니다. 광고, 전자상거래, 제품 디자인, UI·UX, 게임과 영상 프리비주얼라이제이션처럼 여러 자산을 반복 조합하는 업무가 우선 적용처로 제시됐습니다.
‘영상 생성’보다 ‘제작 의도 이해’가 중요해진 이유
짧은 클립의 화질만 높이는 경쟁은 금방 상향 평준화될 수 있습니다. 실무에서 더 큰 비용은 원하는 장면이 나올 때까지 프롬프트를 바꾸고, 생성된 클립을 다시 편집하고, 음향을 맞추며, 브랜드 자산의 일관성을 확인하는 반복 과정에서 생깁니다. 참조 이미지·영상·오디오를 한 문맥으로 다루는 모델은 이 반복 횟수를 줄일 가능성이 있습니다.
H3는 이를 위해 ‘Contextual Omni Representation’이라는 표현을 사용합니다. 목표 영상만 설명하는 캡션이 아니라, 여러 입력 요소의 관계와 최종 결과가 어떻게 이어져야 하는지를 언어로 표현하는 방식입니다. 회사는 새 VAE가 유효 시퀀스 길이를 4배 늘리고, 이해와 생성을 분리한 학습 구조가 처리량을 약 30% 높였다고 설명했습니다. 이 수치는 MiniMax가 공개한 내부 측정치이며 독립적으로 재현된 결과로 보아서는 안 됩니다.
2K 출력도 단순 업스케일러가 아니라 저해상도 결과를 원래 멀티모달 문맥과 함께 다시 생성하는 ‘인컨텍스트 재생성’을 사용한다고 회사는 밝혔습니다. 작은 사물과 글자 같은 세부를 복원하려는 접근이지만, 실제 브랜드명·제품 라벨의 정확성은 장면과 언어마다 별도로 검증해야 합니다.
오픈 웨이트 약속은 아직 ‘예정’이다
이번 발표에서 눈에 띄는 대목은 모델 가중치 공개 계획입니다. MiniMax는 관련 법과 규정을 전제로 수일 내 H3 가중치를 공개하겠다고 밝혔습니다. 따라서 현재 시점에 H3를 이미 완전한 오픈 웨이트 모델이라고 단정하는 것은 이릅니다. 지금 바로 사용할 수 있는 경로는 API와 소비자용 서비스이며, 가중치 파일·라이선스·배포 조건은 실제 공개 뒤 확인해야 합니다.
South China Morning Post는 H3가 Artificial Analysis의 영상 편집 평가에서는 선두로 집계됐지만, 텍스트-투-비디오와 이미지-투-비디오에서는 일부 경쟁 모델보다 뒤에 있다고 보도했습니다. 하나의 종합 순위보다 작업 유형별 편차가 크다는 뜻입니다. “모든 영상 작업에서 최고”라기보다 복합 참조와 편집에서 강점을 겨냥한 모델로 보는 편이 정확합니다.
가격 역시 MiniMax는 2K 기준 초당 비용이 주류 모델의 3분의 1 미만이라고 주장합니다. 비교 대상과 사용량 조건이 명확하지 않은 마케팅 수치이므로, 기업은 생성 성공률·재시도 횟수·후편집 시간·저장 및 전송 비용을 포함한 완성본 1개당 총비용으로 비교해야 합니다.
콘텐츠·개발팀이 확인할 실무 포인트
- 작업별 평가 세트를 만들기: 제품 영상, 인물 일관성, 카메라 모션, 립싱크, 다국어 자막처럼 실제 업무 장면을 나눠 성공률을 측정해야 합니다.
- 멀티모달 입력 권리를 점검하기: 참조 이미지·영상·음성에 대한 사용권과 초상권, 음성 복제 동의를 생성 요청 전에 확인해야 합니다.
- 완성본 비용으로 비교하기: API 단가보다 재생성 횟수, 편집자 시간, 검수와 승인 비용을 합산하는 편이 의사결정에 유용합니다.
- 출처와 생성 이력을 보존하기: 입력 자산, 프롬프트, 모델 버전, 생성 시각과 후편집 이력을 기록해 결과물의 책임 소재를 남겨야 합니다.
- 가중치 공개 후 다시 검토하기: 라이선스, 상업 이용 범위, 하드웨어 요구량, 안전 필터와 업데이트 책임을 확인한 뒤 자체 호스팅 여부를 결정해야 합니다.
전망: 모델 수보다 워크플로 통합력이 경쟁력이 된다
H3의 의미는 2K나 15초라는 숫자 하나보다 서로 다른 생성·편집 작업을 단일 문맥으로 통합하려는 방향에 있습니다. 이 접근이 안정적으로 작동하면 팀은 여러 모델 사이에서 자산을 옮기고 지시를 반복하는 시간을 줄일 수 있습니다. 반대로 한 모델에 더 많은 제작 권한이 모일수록 저작권, 브랜드 안전, 데이터 유출과 결과 추적에 대한 통제도 더 중요해집니다.
앞으로의 비교 기준은 “가장 인상적인 데모를 만들었는가”에서 “실제 제작 파이프라인에서 일관된 결과를 얼마나 적은 수정으로 완성하는가”로 이동할 가능성이 큽니다. H3는 그 변화를 선명하게 보여주는 신제품이지만, 약속된 가중치 공개와 독립 벤치마크, 실제 상업 프로젝트의 재현성이 확인돼야 최종 평가는 가능할 것입니다.
출처
- MiniMax — MiniMax H3: An Open Model Breaking the Boundaries Between Tasks and Modalities
- Reuters — China’s MiniMax releases H3 video model
- South China Morning Post — Video AI: MiniMax challenges ByteDance with low price, open weights for new H3 model
- MarkTechPost — MiniMax H3 technical and API overview