GPT-5.6 공개: Sol·Terra·Luna로 재편된 AI 모델 경쟁
OpenAI가 GPT‑5.6 모델군을 공개했습니다. Sol·Terra·Luna의 차이와 멀티 에이전트, 코딩·보안·지식 업무 변화를 정리합니다.
OpenAI가 2026년 7월 9일 새로운 범용 인공지능 모델군 GPT‑5.6을 정식 공개했습니다. 이번 발표의 핵심은 단순히 더 큰 모델 하나를 내놓은 것이 아닙니다. 성능과 비용에 따라 Sol·Terra·Luna 세 가지 등급을 제공하고, 복잡한 업무를 여러 에이전트가 나눠 처리하는 방식까지 제품 안으로 끌어들였다는 점입니다.
GPT‑5.6은 ChatGPT, Codex, OpenAI API에 순차적으로 제공됩니다. OpenAI는 이번 세대를 코딩뿐 아니라 문서·프레젠테이션·스프레드시트 제작, 웹 탐색, 컴퓨터 조작, 사이버 보안, 과학 연구까지 아우르는 ‘업무 수행형 AI’로 설명하고 있습니다.
하나의 모델이 아니라 세 가지 선택지
GPT‑5.6 모델군은 용도와 예산에 따라 다음과 같이 나뉩니다.
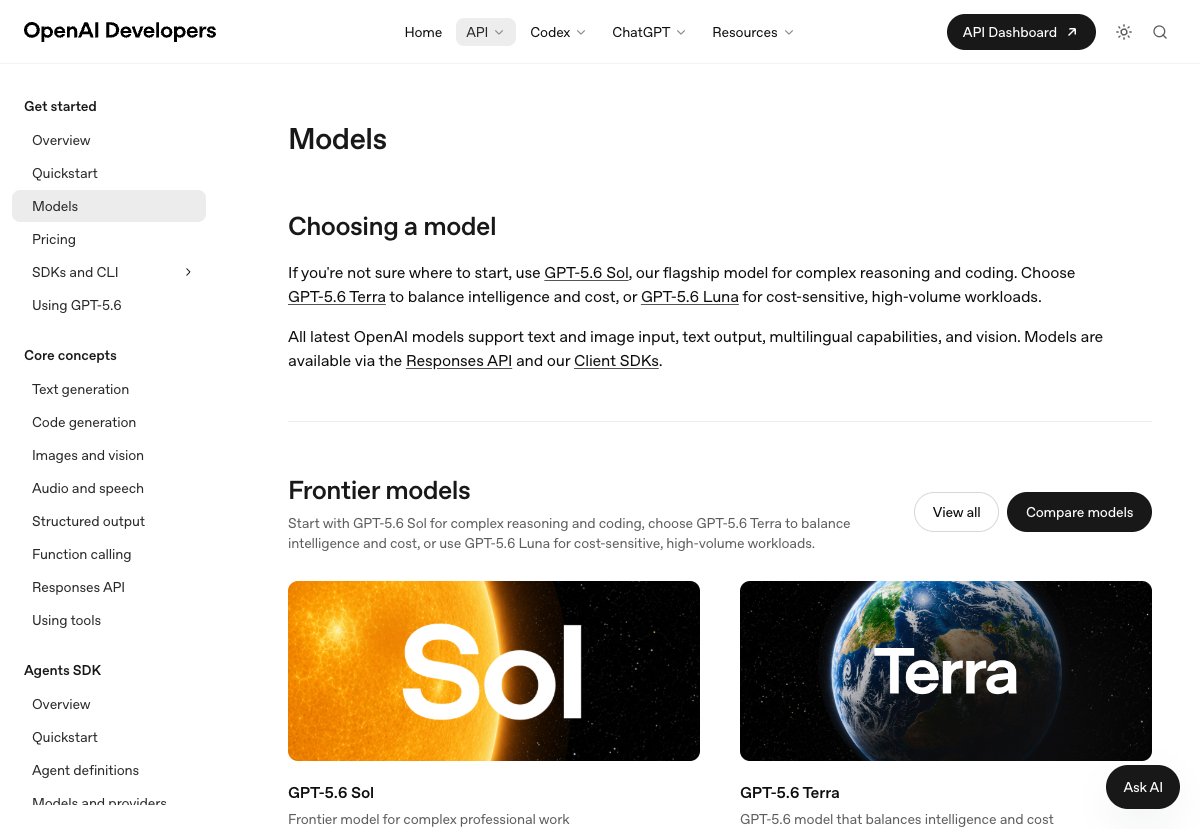
- Sol: 가장 어려운 코딩·연구·분석 작업을 겨냥한 플래그십 모델
- Terra: 지능과 비용의 균형을 맞춘 일상 업무용 모델
- Luna: 빠른 응답과 대량 처리가 필요한 서비스에 적합한 경제형 모델
API 가격은 100만 토큰 기준으로 Sol이 입력 5달러·출력 30달러, Terra가 입력 2.5달러·출력 15달러, Luna가 입력 1달러·출력 6달러입니다. 기업은 모든 요청에 최고급 모델을 쓰기보다 업무 난도에 맞춰 모델을 배치할 수 있게 됐습니다. 고객 문의 분류나 대량 요약은 Luna로, 일반적인 분석과 콘텐츠 제작은 Terra로, 고난도 개발과 복합 연구는 Sol로 보내는 식입니다.
이번 발표에서 더 중요한 것은 ‘성능 대비 비용’
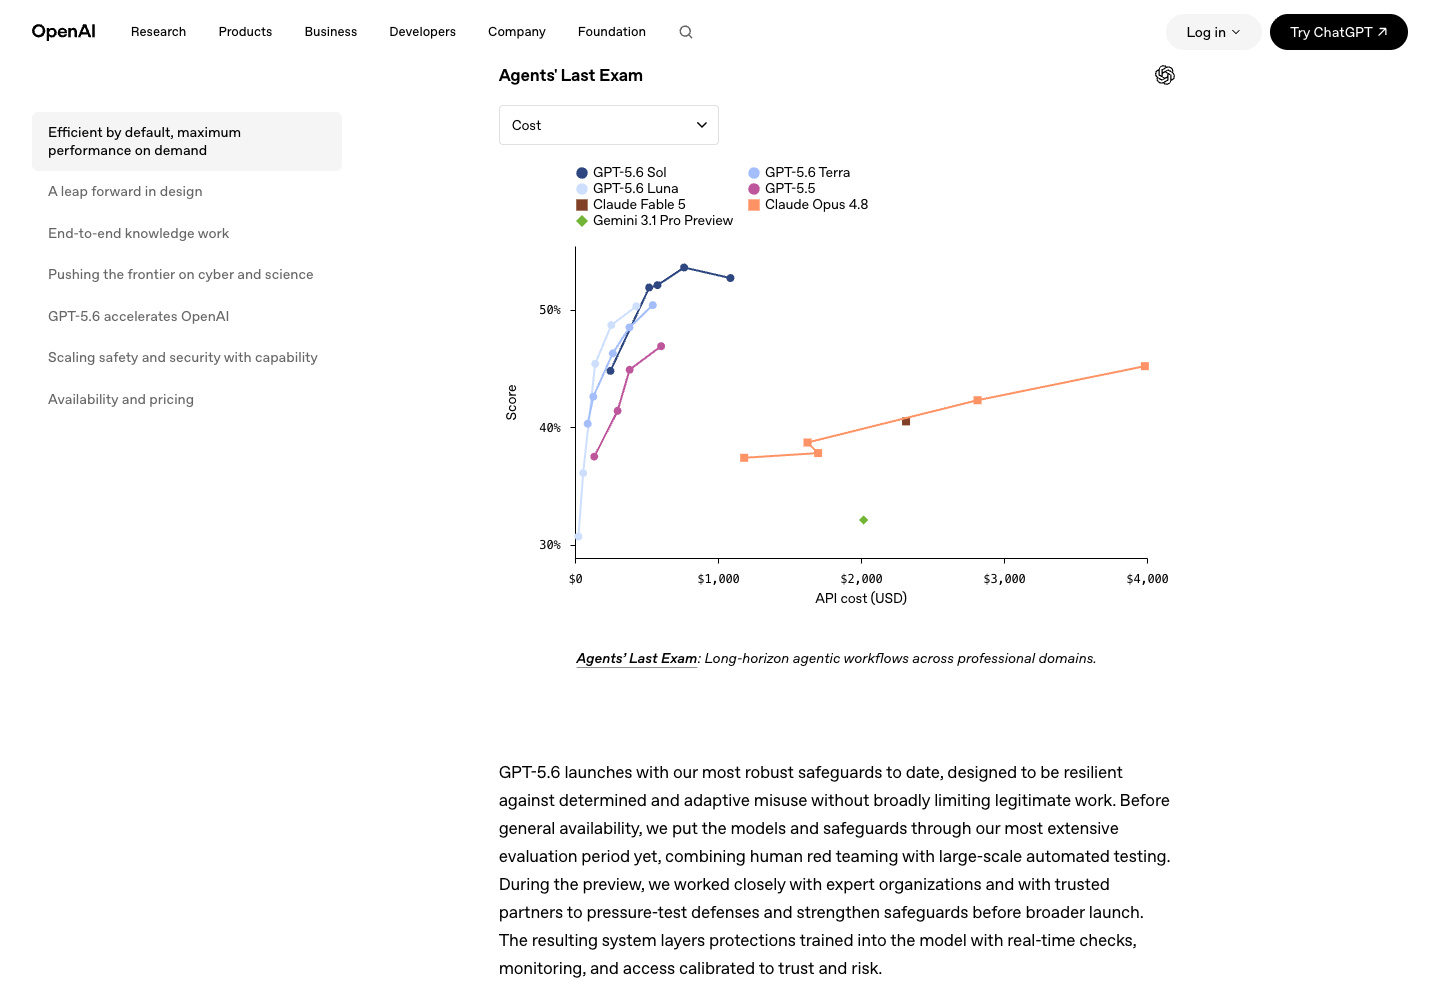
OpenAI는 GPT‑5.6 Sol이 코딩, 지식 업무, 사이버 보안, 과학 분야에서 이전 세대보다 더 적은 토큰으로 높은 성능을 낸다고 주장합니다. 장시간 전문 업무를 평가하는 자체·외부 벤치마크에서도 개선된 결과를 제시했습니다.
다만 벤치마크 숫자는 실제 현장 성능과 동일하지 않습니다. 모델 제공사가 공개한 결과인 만큼, 기업 도입 전에는 자사 데이터와 실제 업무 흐름으로 정확도·응답 시간·총비용을 다시 검증할 필요가 있습니다. 그럼에도 AI 경쟁의 기준이 ‘가장 똑똑한 모델’에서 같은 비용으로 얼마나 많은 일을 끝내는가로 이동하고 있다는 점은 분명해 보입니다.
코딩 도구에서 실제 업무를 끝내는 에이전트로
GPT‑5.6은 단순한 질문·답변보다 여러 단계의 작업 수행에 초점을 맞췄습니다. Responses API에는 프로그램 방식의 도구 호출, 추론 상태 유지, 명시적 프롬프트 캐싱 제어가 추가됐고, 여러 하위 에이전트가 동시에 작업한 결과를 하나로 합치는 멀티 에이전트 기능도 베타로 제공됩니다.
가장 높은 작업 설정인 ultra는 복잡한 과제를 여러 병렬 작업 흐름으로 나눠 처리합니다. 예를 들어 시장 조사, 경쟁사 분석, 데이터 정리, 보고서 작성 같은 업무를 순서대로 하나씩 처리하는 대신 여러 에이전트가 동시에 진행한 뒤 최종 결과를 통합하는 구조입니다.
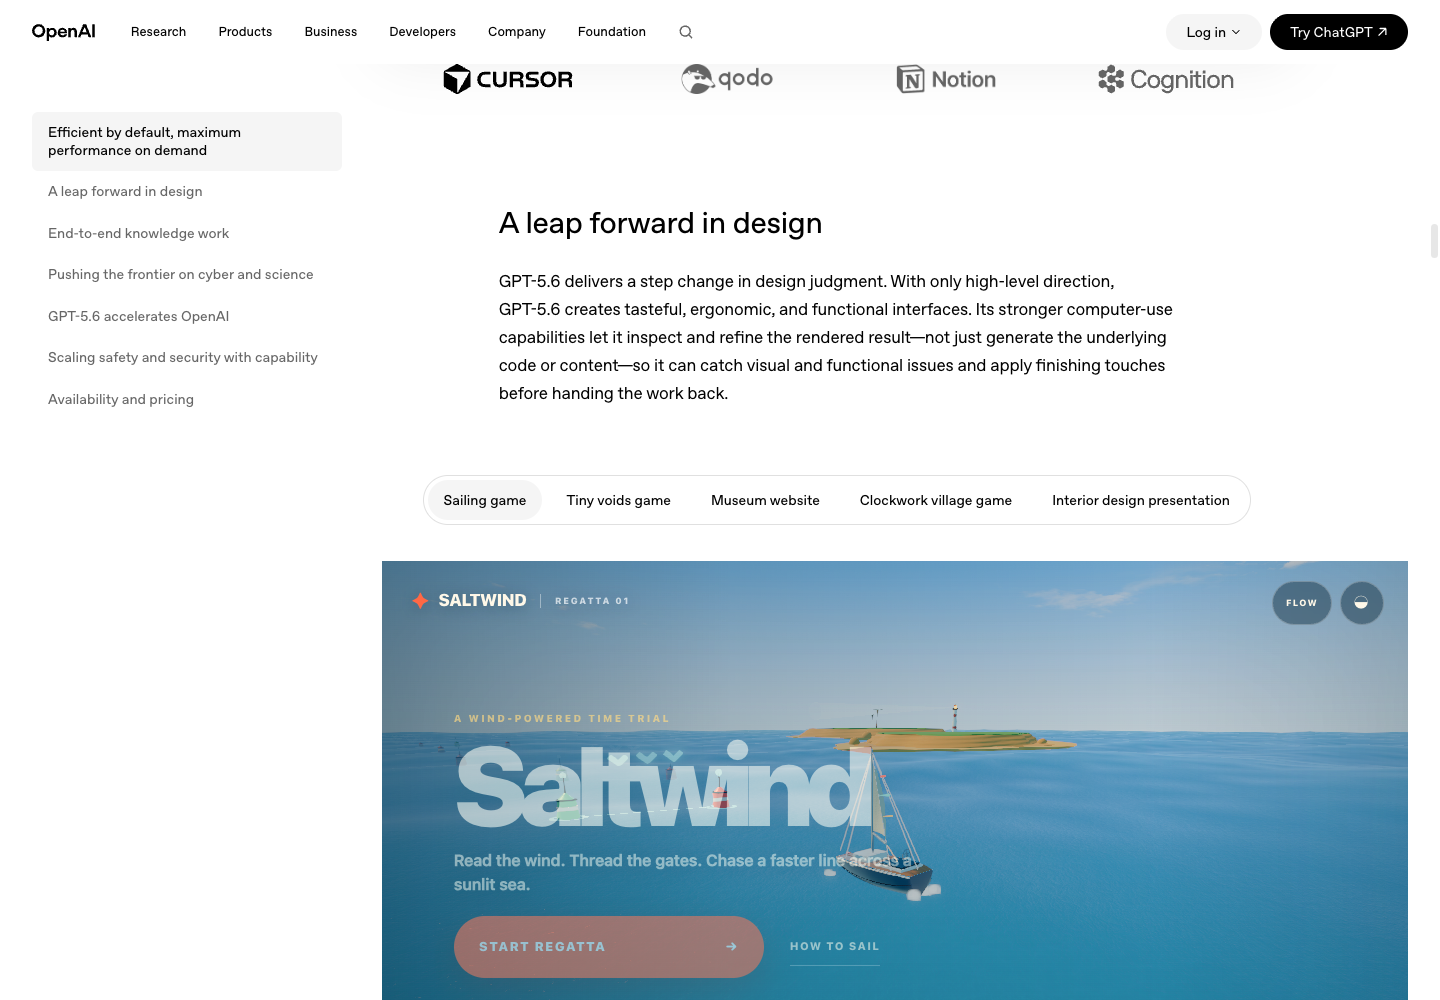
디자인과 컴퓨터 사용 능력도 강화됐습니다. 코드만 생성하는 데서 끝나지 않고 렌더링된 화면을 직접 확인하고, 시각적·기능적 문제를 고쳐 완성도를 높이는 방향입니다. 이는 AI 코딩 도구가 ‘초안 생성기’에서 ‘검수와 마무리까지 맡는 협업자’로 이동하고 있음을 보여줍니다.
사이버 보안 능력 향상, 동시에 커진 안전 부담
OpenAI는 GPT‑5.6을 자사의 가장 강력한 사이버 보안 모델이라고 소개합니다. 위협 모델링, 코드 검토와 패치, 방어 훈련 등 보안 담당자의 업무를 지원할 수 있다는 설명입니다. 회사가 공개한 평가에서는 생물학과 사이버 보안 모두 최고 위험 등급인 ‘Critical’ 기준을 넘지 않았으며, 강화된 다층 안전장치와 실시간 모니터링을 적용했다고 밝혔습니다.
하지만 능력이 높아질수록 오용 가능성도 함께 커집니다. 따라서 기업 환경에서는 모델 자체의 안전장치만 믿기보다 접근 권한, 실행 승인, 감사 로그, 민감정보 차단 정책을 별도로 운영해야 합니다. 특히 AI가 외부 시스템을 직접 조작하는 경우에는 사람이 최종 승인하는 단계를 남기는 것이 안전합니다.
GPT‑5.6이 바꾸려는 시장의 기준
이번 발표는 OpenAI가 Anthropic, Google, Meta 등과 벌이는 모델 경쟁에서 다시 주도권을 확보하려는 움직임으로 읽힙니다. 그러나 사용자 입장에서 더 중요한 변화는 모델 이름이 아니라 선택 구조입니다. 성능·속도·비용이 다른 모델을 한 제품군 안에서 고르고, 복잡한 업무는 여러 에이전트에게 분산할 수 있게 됐기 때문입니다.
앞으로 AI 도입의 성패는 “어떤 모델이 1위인가”보다 “어떤 업무를 어떤 모델과 권한 구조에 맡길 것인가”에 달려 있을 가능성이 큽니다. GPT‑5.6은 그 전환을 보여주는 제품입니다. AI가 답변을 생성하는 도구를 넘어, 실제 업무를 계획하고 실행하고 검수하는 운영 계층으로 확장되고 있습니다.
참고 자료
OpenAI, GPT‑5.6: Frontier intelligence that scales with your ambition
TechCrunch, OpenAI launches its new family of models with GPT‑5.6