Anthropic, AI 안전 목표를 실행 일정으로 구체화하다: Frontier Safety Roadmap 해설
Anthropic은 Frontier Safety Roadmap에서 보안·오용 방지·정렬 목표와 실행 시점을 구체화했습니다. 기업이 AI 에이전트를 도입할 때 적용할 수 있는 권한 설계와 점검 원칙을 살펴봅니다.
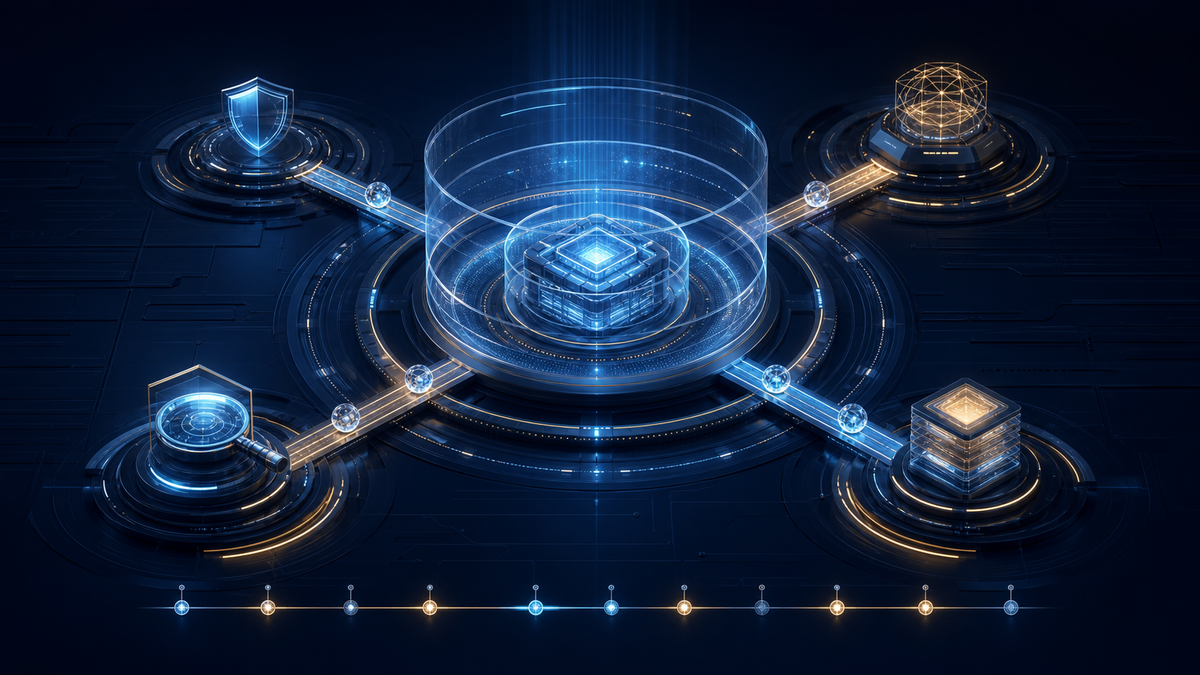
프런티어 AI 경쟁에서 ‘안전’은 선언문만으로는 작동하지 않는다. 누가 무엇을 언제까지 만들고, 실패 여부를 어떻게 공개할지가 있어야 운영 체계가 된다. Anthropic이 2026년 7월 27일 갱신한 Frontier Safety Roadmap은 이 원칙을 보안·오용 방지·정렬·정책의 네 축에 적용했다. 모델 성능 발표가 아니라, 강해지는 에이전트를 실제 조직 안에서 어떻게 통제할 것인지 보여주는 문서라는 점에서 주목할 만하다.
무엇이 달라졌나
로드맵의 핵심은 추상적인 안전 약속을 구체적인 목표와 실행 일정으로 제시한 데 있다. Anthropic은 2026년 9월까지 보안 ‘문샷 R&D’ 프로젝트의 초기 단계를 진행하고, 2027년 7월까지 모델 가중치·학습 환경·내부 시스템 전반의 보안 수준을 끌어올리는 목표를 제시했다. 세부 내용 일부는 공격자에게 방어 구조를 노출할 수 있어 비공개 처리하되, 전체 목표와 달성 여부는 공개적으로 갱신하겠다는 방식이다.
오용 방지 영역에서는 2027년 1월을 목표로 두 가지 자동화를 내걸었다. 하나는 외부 버그바운티 참가자들의 집단적 탐색보다 강한 내부 레드팀 체계를 만드는 것이고, 다른 하나는 사이버 공격 의심 사례를 최소한의 인간 개입으로 조사하는 시스템이다. 후자는 단일 프롬프트를 차단하는 수준을 넘어 여러 계정과 상호작용에서 나타나는 패턴을 추적하는 운영 보안에 가깝다.
정렬 영역은 Claude의 행동이 공개된 Claude 헌법(Claude’s Constitution)에 명시된 원칙과 실제로 일치하는지 체계적으로 평가하는 데 초점을 둔다. 2026년 10월까지 학습 데이터 감독, 행동 성향 평가, 의도적으로 잘못 정렬된 모델을 이용한 검증을 강화하고 결과를 시스템 카드나 위험 보고서에 반영하겠다는 계획이다.
왜 지금 중요한가
최근 모델은 브라우저와 터미널을 사용하고, 장시간 계획을 실행하며, 코드와 시스템 설정을 직접 바꾸는 방향으로 진화하고 있다. Anthropic의 Transparency Hub도 최신 Claude 계열이 계획·도구 사용·자율 실행 능력을 갖췄다고 설명한다. 이런 모델에서는 부정확한 답변 하나보다 권한이 큰 자동화가 잘못된 목표를 오래 수행하는 문제가 더 위험할 수 있다.
로드맵이 ‘eyes on everything’이라고 표현한 내부 개발 활동의 중앙 기록과 AI 기반 분석을 강조하는 이유도 여기에 있다. 모델 학습, 중요 코드 변경, 권한 사용, 데이터 접근을 나중에 재구성할 수 있어야 내부자 위협과 모델의 이상 행동을 조사할 수 있다. 이는 일반 기업의 에이전트 도입에도 그대로 적용된다. 에이전트가 한 일을 채팅 로그만으로 남기는 대신 도구 호출, 승인자, 변경 전후 상태, 외부 전송 기록을 구조화해 보관해야 한다.
기업이 바로 가져올 수 있는 네 가지 원칙
- 기능보다 권한을 먼저 분류한다. 이메일 초안 작성과 실제 발송, 코드 제안과 운영 서버 배포는 위험이 다르다. 모델 이름이 아니라 실행 권한을 기준으로 승인 단계를 나눠야 한다.
- 실시간 차단과 사후 조사를 분리한다. 즉시 막아야 할 행위는 저지연 필터가 처리하고, 복잡한 패턴은 비동기 분석이 맡도록 설계하면 안전성과 사용성을 함께 확보할 수 있다.
- 레드팀¹을 일회성 출시 점검으로 끝내지 않는다. 도구와 데이터가 바뀔 때마다 공격 경로도 달라진다. 실제 업무 시나리오를 기반으로 반복 평가하고 새 실패 사례를 회귀 테스트에 추가해야 한다.
- 중단 조건을 문서화한다. 사고율, 비정상 권한 사용, 평가 기준 미달처럼 자동화를 축소하거나 멈출 조건을 배포 전에 정해야 한다.
읽을 때 주의할 점
이 문서는 성과 보고서가 아니라 미래 목표를 담은 로드맵이다. 목표 날짜가 있다고 해서 기술적 실현 가능성이나 효과가 이미 검증된 것은 아니다. Anthropic도 계획이 바뀔 수 있으며 일부 목표는 실행 과정에서 수정될 수 있다고 밝힌다. 또한 내부 환경을 광범위하게 기록하는 방식은 보안에 도움이 되지만 직원 프라이버시, 데이터 보존 기간, 접근 통제 같은 별도 거버넌스가 필요하다.
회사의 자체 평가만으로 충분하다고 보기도 어렵다. Anthropic의 Responsible Scaling Policy는 위험 보고서의 외부 검토와 공개 범위를 규정하지만, 민감한 부분은 비공개로 남는다. 고객과 정책 담당자는 공개 목표, 실제 달성 여부, 독립 검토의 범위를 함께 봐야 한다.
결론: AI 안전이 제품 운영의 언어로 이동한다
이번 로드맵의 의미는 ‘안전한 AI’를 주장한 데 있지 않다. 보안 강화, 자동화된 공격 조사, 정렬 평가, 감사 가능한 개발 기록을 책임 주체와 목표 시점을 명시한 실행 계획으로 구체화했다는 데 있다. 에이전트가 더 많은 권한을 갖는 시대에는 모델 성능표만큼 권한 설계·관찰 가능성·중단 절차가 중요하다. 기업이 이 문서에서 가져가야 할 가장 현실적인 교훈도 바로 그것이다.
각주
- 레드팀(Red Team): 시스템의 취약점을 찾기 위해 공격자 관점에서 모의 공격을 수행하는 안전성 검증 조직 또는 활동을 뜻한다. AI 분야에서는 탈옥, 프롬프트 인젝션, 데이터 유출, 권한 오용 가능성 등을 시험한다.
참고 자료
- Anthropic, Frontier Safety Roadmap (2026-07-27 확인)
- Anthropic, Responsible Scaling Policy (v3.4, 2026-07-08)
- Anthropic, Transparency Hub (2026-07-24 갱신 확인)