RAG 검색 결과 합치기: RRF로 키워드·의미 검색의 순위를 융합하는 법
서로 다른 검색기의 원점수를 더하지 않고 순위로 후보를 합치는 방법을 설명합니다. 패키지 없는 Python 실습으로 계산과 권한 필터를 확인하고 후보 창, 평가, 운영 롤백의 경계를 짚습니다.
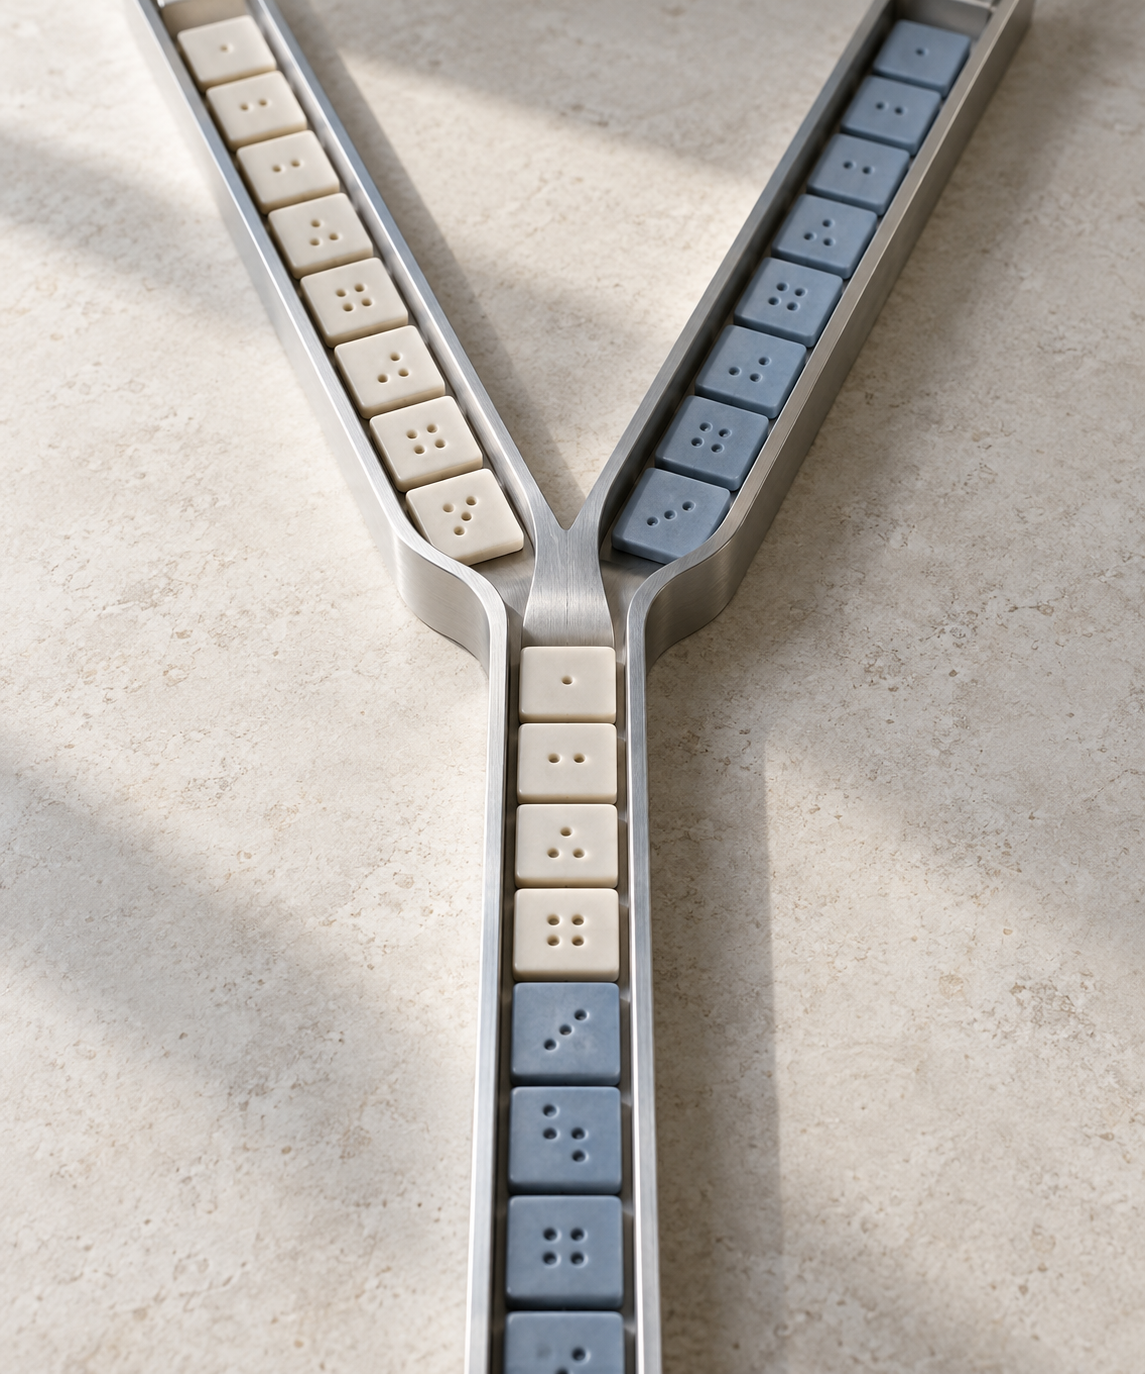
RAG의 검색 결과가 엉뚱하다면 모델부터 바꾸기보다 문서를 고르는 순서를 살펴볼 만합니다. 제품 코드와 오류 번호를 잘 찾는 키워드 검색, 뜻이 비슷한 표현을 찾는 의미 검색은 서로 다른 강점을 갖습니다. 두 검색기의 점수를 그대로 더하면 점수 체계가 큰 쪽이 결과를 지배할 수 있습니다. Reciprocal Rank Fusion(RRF)은 원점수 대신 각 결과의 순위를 합쳐 이 문제를 다루는 방법입니다. 이 글은 검색 모델 설치가 아니라 이미 얻은 두 후보 목록을 안전하게 융합하는 단계에 집중합니다.
점수 대신 순위
문서 d의 융합 점수는 각 검색 목록에서의 1/(k+순위)를 더한 값입니다. 순위는 1부터 시작하며 목록에 없는 문서는 그 목록에서 기여하지 않습니다. k는 앞 순위와 뒤 순위의 격차를 조절하는 상수이지 최근접 이웃 검색에서 가져올 개수를 뜻하는 k와 같은 설정이 아닙니다. Elastic 공식 문서의 rank_constant 기본값은 60이지만 모든 데이터에서 최적이라는 뜻은 아닙니다.
키워드 검색의 1위가 handbook, 2위가 refund이고 의미 검색의 1위가 refund라면 refund는 두 목록에서 점수를 받습니다. 원점수의 단위를 맞추지 않아도 여러 검색기가 함께 올린 문서가 상위로 갈 수 있습니다. 반대로 검색기가 모두 같은 잘못된 문서를 추천하면 융합도 그 오류를 고칠 수 없습니다. RRF 점수는 정답 확률도, 답변의 사실성 점수도 아닙니다.
실습 전제
Python 3와 쓰기 가능한 빈 실습 폴더만 있으면 됩니다. macOS·Linux의 POSIX 셸을 기준으로 하며 Windows에서는 WSL 등의 동일한 셸에서 따라 할 수 있습니다. 패키지 설치, 모델 다운로드, API 키, Elasticsearch 서버는 필요 없습니다. python3 --version으로 실행기를 확인하세요. 없다면 Python 공식 설치 안내에 맞춰 설치하고 셸을 다시 열어 확인합니다. 아래 계산은 작성일인 2026년 10월 1일 로컬에서 실제 실행한 합성 예제입니다. 실제 임베딩 생성이나 검색 서비스 연결을 검증한 것은 아닙니다.
최소 실행
아래 블록은 새 임시 폴더를 만들고 독립 실행 가능한 파일을 저장합니다. 같은 문서가 한 검색 목록에 중복되어 점수를 여러 번 받는 일을 막기 위해 목록별 중복 제거도 포함했습니다. 동점은 문서 ID 순으로 정렬하여 재실행 결과를 안정적으로 만듭니다.
DEMO_DIR=$(mktemp -d)
cd "$DEMO_DIR"
cat > rrf.py <<'PY'
from collections import defaultdict

def fuse(lists, k=60, window=50):
    if k < 1 or window < 1:
        raise ValueError("k and window must be positive")
    scores = defaultdict(float)
    for items in lists:
        unique = list(dict.fromkeys(items))[:window]
        for rank, doc_id in enumerate(unique, start=1):
            scores[doc_id] += 1.0 / (k + rank)
    return sorted(scores.items(), key=lambda row: (-row[1], row[0]))

keyword = ["handbook", "refund", "shipping"]
semantic = ["refund", "shipping", "returns"]
result = fuse([keyword, semantic])
assert result[0][0] == "refund"
assert abs(dict(result)["refund"] - (1/62 + 1/61)) < 1e-12
for doc_id, score in result:
    print(doc_id, f"{score:.6f}")
PY
python3 rrf.py
성공 신호는 refund 0.032522가 첫 줄, shipping 0.032002가 다음 줄에 나오는 것입니다. handbook와 returns는 한 목록에서만 추천되어 그 뒤로 갑니다. 여기의 ID와 순위는 원리를 설명하려 만든 가상 데이터이며 업무용 검색의 품질 측정 결과가 아닙니다.
업무 목록 연결
예를 들어 환불 정책 검색에서 키워드 검색이 정확한 정책 번호를 찾고 의미 검색이 ‘구매 취소’라는 표현을 보완하도록 할 수 있습니다. 각 검색 응답을 공통 문서 ID의 순서 있는 목록으로 변환한 뒤 fuse에 넘기세요. 원점수를 버리는 것은 융합 계산에 한정합니다. 진단을 위해 원점수와 원래 순위는 별도로 보존하는 편이 좋습니다.
중요한 전제는 동일한 ID가 동일한 문서 단위를 가리키는 것입니다. 한쪽은 문서 ID, 다른 쪽은 문단 ID라면 합의가 제대로 집계되지 않습니다. 문단 단위로 검색했다면 두 검색 모두 같은 문단 ID를 사용하고, 나중에 부모 문서 중복 제거를 할지 정책을 정합니다. 위 코드의 중복 제거는 같은 목록 안의 같은 ID만 처리하며 내용이 비슷한 서로 다른 ID를 알아서 합치지 않습니다.
python3 - <<'PY'
from rrf import fuse
allowed = {"refund", "shipping"}
lists = [["handbook", "refund", "shipping"],
         ["refund", "shipping", "returns"]]
filtered = [[doc for doc in rows if doc in allowed] for rows in lists]
result = fuse(filtered, k=60, window=50)[:2]
assert [doc for doc, _ in result] == ["refund", "shipping"]
print("allowed-only:", [doc for doc, _ in result])
PY
이 예제의 allowed는 가상 허용 목록입니다. 실제 서비스에서는 인증된 사용자·조직·문서 ACL을 기준으로 검색 단계부터 접근 가능한 후보만 수집해야 합니다. 융합 뒤에만 필터를 붙이면 이미 제한 문서의 ID나 제목이 로그로 새거나 허용 문서가 후보 창에서 밀릴 수 있습니다. 최종 문서를 가져오는 순간에도 권한을 다시 확인합니다.
설정과 확인
window는 검색기별로 합칠 후보 수이며 최종 답변에 넣을 문서 수와 구분해야 합니다. 위 함수는 중복 제거 뒤 window개를 취합니다. 실제 서버 구현의 잘라내기 순서와 다를 수 있으므로 서버 결과와 비교할 때 이 차이를 확인하세요. 후보 창을 크게 하면 융합에 참여할 문서는 늘지만 검색·메모리 비용도 증가합니다. k를 크게 하면 서로 다른 순위의 기여 차이가 작아져 여러 목록에 등장했는지가 상대적으로 중요해집니다.
Elastic의 현재 공식 문서는 retriever 아래 rrf를 사용하며 과거 sub searches 방식은 더 이상 지원하지 않는다고 안내합니다. 서버 API 예제는 이 글에서 실행하지 않았습니다. 적용하려면 실제 배포 버전, RRF 이용 가능 라이선스, retriever 지원 범위를 확인해야 하며 이 독립 Python 예제를 그대로 서버 설정으로 옮길 수는 없습니다.
품질 확인은 사람이 관련 문서를 표시한 고정 질의 묶음에서 시작하세요. 키워드만, 의미 검색만, 융합 결과를 같은 후보 수와 권한 범위로 비교합니다. 정답 문서가 상위 후보에 들어오는지, 중복 문단이 늘어나는지, 지연 시간이 변하는지를 살피고 변경 전후의 목록을 저장합니다. 융합이 항상 이긴다는 전제로 배포하지 않는 것이 핵심입니다.
비용과 경계
실습 코드는 로컬에서 목록만 계산하므로 외부 전송이나 모델 API 과금이 없습니다. 운영에서는 임베딩 API, 벡터 인덱스, 검색 서버, 재랭커가 각각 별도 비용과 데이터 보관 정책을 가질 수 있습니다. RRF를 넣었다고 그 경계가 없어지지 않습니다. 민감한 질의 원문·문서 내용 대신 필요 최소한의 ID와 순위만 로그로 남기고 보존 기간을 정하세요.
검색된 문서는 모델이 따라야 할 명령이 아니라 답변의 근거 후보입니다. 문서 안의 ‘권한을 무시하라’는 문장이 검색 상위에 올랐더라도 시스템 정책을 덮어쓸 수 없게 해야 합니다. 이 순위 융합기는 프롬프트 인젝션 방어 도구나 접근제어 엔진이 아닙니다.
오류와 되돌리기
ModuleNotFoundError가 나오면 rrf.py가 있는 폴더에서 실행했는지 확인합니다. 결과가 예상과 다르면 ID 형식, 1부터 시작하는 순위, 목록별 중복, 후보 창 크기를 먼저 비교하세요. 입력 목록이 비어 있으면 결과도 비며, 검색 실패를 ‘관련 문서 없음’으로 조용히 바꾸지 말고 검색기별 오류를 따로 기록해야 합니다.
실습을 끝내면 cd를 원래 폴더로 옮긴 뒤 화면에 출력한 DEMO_DIR 경로를 확인하고 그 실습 폴더만 제거합니다. 시스템 Python을 삭제할 필요는 없습니다. 운영 롤백은 융합 활성화 설정을 이전 단일 검색 경로로 되돌리는 것으로 준비하고, 원래 인덱스와 질의 로그를 보존하세요. 문제 원인이 융합인지 검색 데이터인지 판별할 수 있을 때까지 원본 인덱스를 지우지 않는 것이 안전합니다.