한국어 의미 검색, Sentence Transformers로 직접 만들기
다국어 임베딩으로 한국어 문장을 로컬에서 검색하는 최소 예제부터 유사도 해석, 문서 확장, 개인정보와 문제 해결까지 안내합니다.
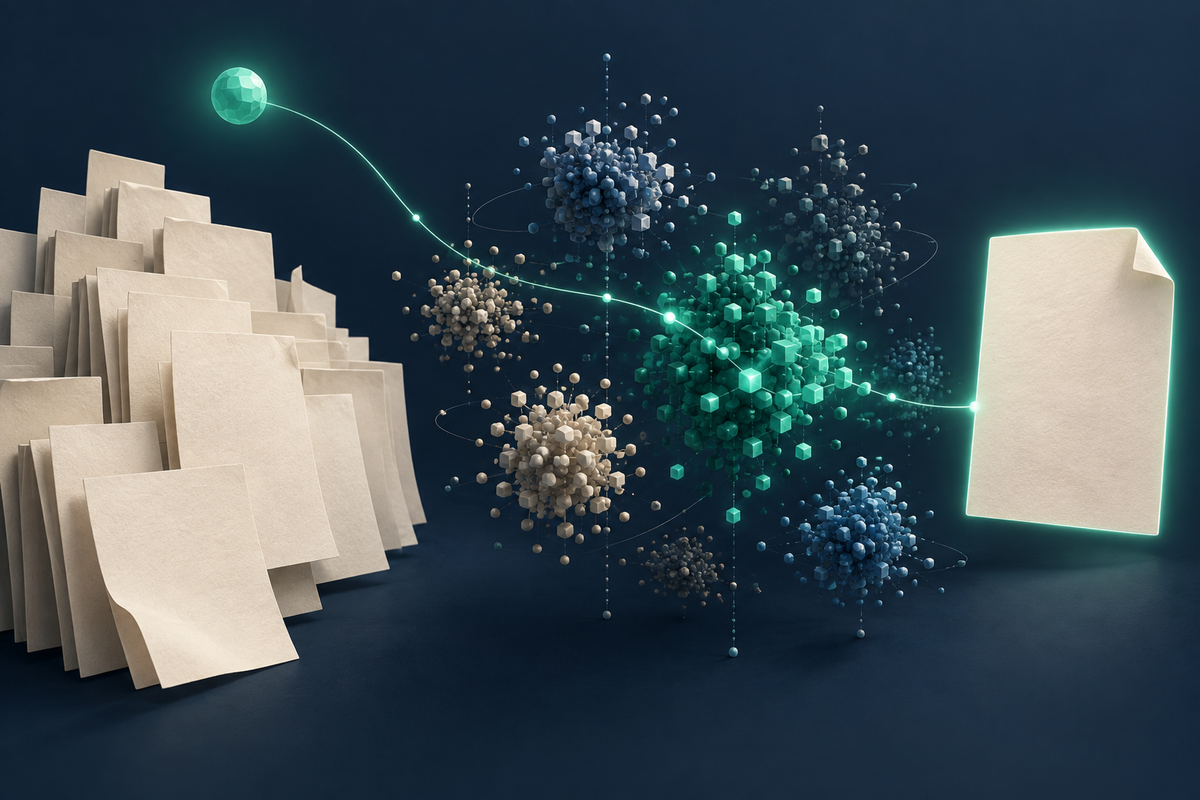
문서 제목에 같은 단어가 없어도 원하는 내용을 찾고 싶을 때가 있다. ‘결제 취소는 며칠 걸려?’라는 질문으로 ‘환불은 영업일 기준으로 처리한다’는 문장을 찾아내는 식이다. 이 글은 Sentence Transformers의 다국어 임베딩 모델로 한국어 문장 네 개를 로컬에서 검색하는 가장 작은 예제를 만든다. 챗봇이나 벡터 데이터베이스부터 시작하지 않고, 검색이 실제로 무엇을 계산하는지 살핀다.
무엇을 만드는가
문서와 질의를 같은 모델로 벡터로 바꾼 뒤 코사인 유사도를 계산한다. 점수가 높은 문장을 위에 보여주는 방식이다. 모델은 답을 생성하지 않으며, 검색된 문장이 근거 후보가 된다. 이 예제의 목표는 의미가 비슷한 문장 찾기이지 사실 검증이나 질문 응답 자동화가 아니다.
준비와 설치
공식 문서는 Python 3.10 이상, PyTorch 2.2 이상을 권장한다. 첫 실행 때 모델 파일을 Hugging Face에서 내려받으므로 인터넷 연결과 저장 공간이 필요하다. 다운로드 뒤에는 로컬에서 추론하지만 설치까지 완전한 오프라인인 것은 아니다. GPU가 꼭 필요하면 운영체제별 PyTorch 설치 안내를 확인한다. 작은 예제는 CPU로도 시작할 수 있다.
mkdir korean-semantic-search
cd korean-semantic-search
python3 -m venv .venv
source .venv/bin/activate
python -m pip install -U pip
python -m pip install -U sentence-transformers
python -m pip show sentence-transformers
Windows PowerShell에서 활성화 명령은 .venv\Scripts\Activate.ps1이다. 설치된 패키지 정보를 확인했으면 다음 파일을 만든다. 아래 명령과 API는 공식 문서 기준이며 모든 OS·GPU에서 직접 실행 검증한 것은 아니다.
최소 실행
다음 코드를 search.py로 저장한다. 모델은 다국어 문장을 384차원 벡터로 변환한다. 공식 검색 예제처럼 문서와 질의에 각각 encode_document, encode_query를 사용한다.
from sentence_transformers import SentenceTransformer

model = SentenceTransformer(
    "sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2"
)
documents = [
    "환불은 승인 후 영업일 기준 3~5일 이내에 처리됩니다.",
    "배송지는 상품이 출고되기 전까지 수정할 수 있습니다.",
    "비밀번호 변경은 계정 설정에서 진행하세요.",
    "영수증은 주문 내역에서 내려받을 수 있습니다.",
]
query = "결제 취소한 돈은 언제 돌아오나요?"

doc_embeddings = model.encode_document(documents)
query_embedding = model.encode_query(query)
scores = model.similarity(query_embedding, doc_embeddings)[0]
ranked = sorted(range(len(documents)), key=lambda i: float(scores[i]), reverse=True)
for i in ranked[:3]:
    print(f"{float(scores[i]):.3f}  {documents[i]}")
python search.py출력에서 환불 처리 문장이 상위에 나오는 것이 기대 신호다. 정확한 유사도 숫자와 순위는 모델·패키지 버전과 문장 변경에 따라 달라질 수 있다. 숫자에 임의의 합격선을 적용하지 말고 실제 문맥이 맞는지 확인한다.
검색 흐름
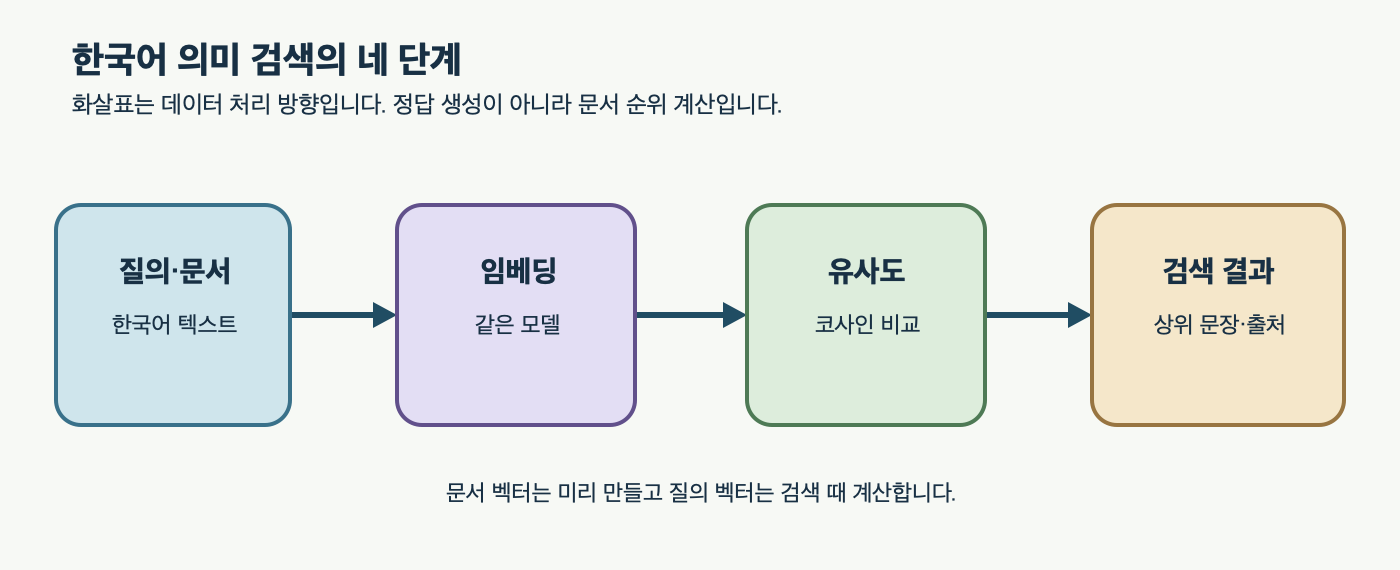
문서 벡터는 자료가 바뀔 때 다시 계산하고, 질의 벡터는 검색할 때 계산한다. 작은 자료 집합은 모든 문서와 직접 비교할 수 있다. 코사인 유사도는 벡터 간 방향의 유사성이지 ‘정답일 확률’이 아니다.
실제 문서로 확장
문서 전체를 한 벡터로 압축하기보다 의미가 유지되는 문단 단위로 나누고 문서 ID, 제목, 원본 경로를 함께 저장한다. 그래야 검색 결과에서 출처를 추적할 수 있다. PDF·HTML 추출 시 표, 머리글, 각주가 섞이면 검색 품질이 떨어진다. 먼저 깨끗한 텍스트와 사람이 정답을 확인한 작은 평가 질의 묶음을 준비한다. ‘환불 언제’, ‘결제 취소 처리 기간’, ‘주문 취소 소요 시간’처럼 다른 표현으로 같은 문장을 찾는지 비교한다.
이 모델은 짧은 다국어 문장 검색의 출발점이다. 긴 질문에서 긴 문단을 찾는 비대칭 검색에는 전용 검색 모델을 평가해야 한다. 공식 문서도 길이가 비슷한 문장을 찾는 대칭 검색과 짧은 질의에서 긴 문단을 찾는 비대칭 검색을 구별한다. 문서 수가 많아지면 벡터 색인·배치 처리·재순위화·갱신 전략을 별도로 설계해야 한다.
설정과 경계
model.similarity(query_embedding, doc_embeddings)는 기본 코사인 유사도로 점수를 만든다. 문장 배열 순서가 바뀌면 인덱스도 바뀌므로 실제 서비스에서는 문서 ID와 벡터를 함께 관리한다. 한 요청에서 ranked[:3]은 상위 3개만 보여주는 출력 옵션일 뿐 품질을 개선하지 않는다. 모델 버전을 바꿀 때는 문서와 질의를 같은 새 모델로 다시 임베딩하고 이전 점수와 직접 비교하지 않는다.
추론은 로컬에서 하지만 최초 모델 다운로드 시 외부 서비스에 접속한다. 사용자 문서를 외부 API에 전송하지 않는 예제라도 모델 라이선스와 조직의 반입 정책을 확인하자. 개인정보·기밀이 있으면 로그·출력에도 노출하지 않는다. CPU 메모리와 저장 공간을 사용하고 GPU 사용 시 드라이버 및 메모리 요구량이 달라진다. 대규모 운영 비용은 네 문장 예제로 추정할 수 없다.
문제 해결
ModuleNotFoundError: 활성화한 가상환경의python으로 설치·실행했는지 확인한다.python -m pip show sentence-transformers로 설치 위치를 확인한다.- 모델 다운로드 실패: 네트워크, Hugging Face 접근 정책, 캐시 저장 공간을 확인한다. 제한된 조직 네트워크에서는 승인된 모델 배포 경로를 쓴다.
- 엉뚱한 결과: 원문 추출 오류, 지나치게 긴 문단, 모델의 언어·검색 용도 적합성을 점검한다. 평가 질의와 기대 문장을 사람이 검수한다.
- 메모리 부족: 한 번에 처리하는 문서 수를 줄이고 CPU부터 시험한다. 작은 문장 검색과 대량 색인은 요구 자원이 다르다.
제거와 복구
실습 폴더에는 가상환경과 search.py가 있다. 필요한 코드를 보관한 뒤 deactivate로 환경에서 나와 실습 폴더를 삭제하면 된다. 공유 Hugging Face 캐시는 다른 프로젝트도 사용할 수 있으므로 캐시 전체를 무심코 삭제하지 않는다. 실제 문서를 입력했다면 출력 파일과 터미널 기록에도 민감한 문장이 남지 않았는지 확인한다.